; oi

2015年6月28日日曜日

今更聞けない基本的な確率分布のまとめ

忘れがちな以下の4つの確率分布についてまとめておく。

ベルヌーイ分布 (Bernoulli distribution)

確率 $\lambda$で 1 を、確率 $1-\lambda$ で 0 をとる、離散確率分布である。

$P(x\mid \lambda) = \lambda^x(1-\lambda)^{(1-x)}$ for $ x \in \{0,1\} $

Takes a single parameter $\lambda \in [0,1] $

カテゴリカル分布 (Categorical distribution) 

ベルヌーイ分布を一般化した確率分布で、二値ではなく、$K$値の場合をとる離散確率分布である。
※ベルヌーイ分布はカテゴリカル分布のカテゴリ数が2の場合ともいえる。
※ どういうわけか、日本語Wikipediaにはカテゴリカル分布の記事は存在しないため、多項分布と混乱されやすい。

$$P(x\mid \boldsymbol{\lambda}) = \displaystyle \prod_{ i = 0 }^K \lambda_i^{x_i} $$

Takes $K$parameters $\lambda_i \in [0,1] $ where $\displaystyle \sum_{ i = 1 }^{ K } \lambda_i = 1$

二項分布 (Binomial distribution)

n 個の独立なベルヌーイ試行の「成功」の数の確率分布であり、各試行の「成功」確率$\lambda$は同じである。
※ベルヌーイ分布は二項分布における試行回数が1回の場合ともいえる。

$$
P(x\mid \lambda, n) = {}_n \mathrm{ C }_x \lambda^x(1-\lambda)^{(n-x)}
$$
$${}_n \mathrm{ C }_x = \frac{ n! }{ x! ( n - x )! }$$

多項分布 (Multinomial distribution)

二項分布を一般化した確率分布である。多項分布では、各試行の結果は固定の有限個($K$個)の値をとる。
※カテゴリカル分布は多項分布の試行回数が1回の場合ともいえる。
※二項分布は多項分布のK=2の場合である。

$$
P(x\mid \boldsymbol{\lambda}, n) =
  \begin{cases}
     \frac{ n! }{ x_1! x_2! \cdots x_k! } \displaystyle \prod_{ i = 1 }^K \lambda_i^{x_i}   & (when \sum_{ i = 1 }^{ K } x_i = n ) \\
    0 & ( otherwise )
  \end{cases}
$$

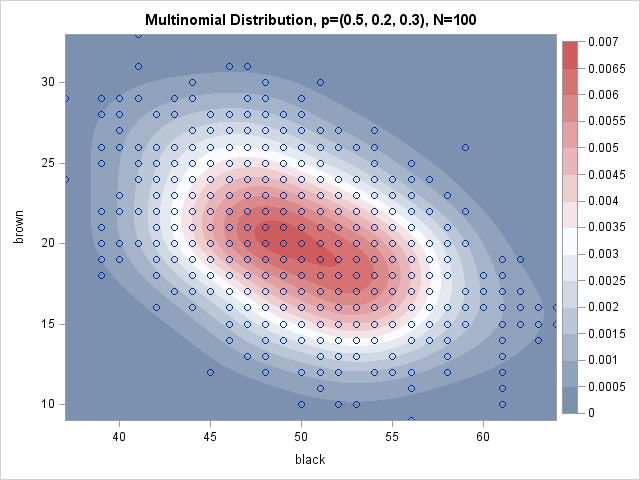
多項分布の例

SASブログより、100足の靴下を取り出す場合($n=100$)、何色の靴下を何回抽出するかという分布例を以下に示す。靴下の色は(黒、茶、白)の三種類であり($K=3$)。それぞれ確率は$\lambda_{black}=0.5,\lambda_{brown}=0.2,\lambda_{white}=0.3$である。

4つの分布の関係性

最後に、以上4つの分布の関係性をまとめると、以下の図になる。カテゴリ数と試行回数によって、最も一般化されたのが多項分布である。このように関連づけて4つの分布を覚えておけば忘れない、、に違いない。

$$
\require{AMScd}
\begin{CD}
Bernoulli(K=2,n=1) @>{K>2}>> Categorical(K>2,n=1)\\
@V{n>1}VV {} @VV{n>1}V\\
Binomial(K=2,n>1)  @>>{K>2}> Multinomial(K>2,n>1)
\end{CD}
$$

$$
\diamondsuit K:カテゴリ数\\
\diamondsuit n:試行回数
$$


2015年6月23日火曜日

The Google Similarity Distance (Rudi L. Cilibrasi, Paul M. B. Vitanyi著)

Rudi L. Cilibrasi, Paul M. B. Vitanyi著

検索エンジン「グーグル」を用いて、2つのものの関係性を表すという主旨の論文。

Information Distance とKolmogorov Complexity に基づいた、二つのオブジェクト、とりわけ語句の関係性を表す指標であるNormalized Information Distanceが定義されたが、これはコルモゴロフ複雑性を内包しているため、コンピュータで計算できない。そこでNormalized Compression Distanceというものが提唱された。これはコルモゴロフ複雑性K(x)を圧縮関数C(x)で近似したものである。コンピュータ上で関数を圧縮関数を指定すればNCDは計算できる。
そして本論文はその圧縮関数C(x)をグーグルサーチエンジンを用いてさらにG(x)として近似する物である。圧縮=グーグルの接頭コードという発想である。
以下NGD。f(x)はxのグーグルサーチエンジンが返すxを含むページ数である。


さらにSVMと組み合わせるなどして、精度の向上にも努めている。

また、検証実験としてWordNetとの比較も行っており、erectrical termsについては100%の精度でwordnetと一致するなどといった結果もでている。


Wikipediaと同様に外部ソースを使った語句相関指標として使ってみたい。

Automatic Keyphrase Extraction via Topic Decomposition (Zhiyuan Liu, Wenyi Huang, Yabin Zheng, Maosong Sun 著)

Zhiyuan Liu, Wenyi Huang, Yabin Zheng, Maosong Sun 著

目的は文書からキーフレーズを抽出すること。
共起関係からできあがった語の共起ネットワークを解析することで重要な語を抽出する。
解析アルゴリズムとしては誰もがお世話になっているグーグルのPageRankを応用する。(Topical PageRank)

どのように応用するか?

この論文は「語はそのトピックに依存する」というのがポリシー。
つまりより良いキーフレーズはその文書の主要なトピックと関係が強くあるべきであり、またより良いキーフレーズはその文書の全てのトピックを網羅すべきであるといった具合だ。

そこでTopical PageRankアルゴリズムを提案する。
基本ステップは以下の通りである。
1.トピックを判断する分類器の作成
2.トピックを考慮してPageRankアルゴリズムを改善

これが全体の概要の図。

ステップ1のためにはLatent Dirichlet Allocationを利用する。
これにより、あるトピックzが与えられたときに語wが起こる確率P(w|z)、及びP(z|w)を求める。
トピックの分布と語の分布を分けて考えて学習させるっていう感じ。詳しくは論文を参照されたい。

ステップ2ではPageRankアルゴリズムをトピックを考慮したものに変形する。
まずこれが本家のPageRank。


R(wi)が大きいほどグーグル検索上位になるわけだ。
e(wi,wj)はwi→wjのエッジの重み。O(wj)はwjを起点として他のノードに向うエッジのeの和(Σe)。
つまりΣの中身は(あるノードwjの重要度:R(wj))×(wjから見たwiの重要さの割合:e/Σe)ということである。Σ全体でノードwiの重要度を示しているというわけ。
また|V|は対象としている語の数、つまりΣw。その逆数1/|V|はランダムでそのノードに来る確率だと考えて良い。またλは普通にリンクをたどって、wiにくる場合とランダムでくる場合の比を表す。
本家グーグルではλ=0.85だそうだ。
このマルコフ連鎖の定常分布を求めることが、PageRankにおける重要度を求めることであった。

さて、ではTPRの場合はどうか。
TPRは以下のようになる。


なんのことはなく、ランダムでwiに遷移する確率がPzとなっただけである。
このPzはトピックに依存した確率であり、Σ [w] Pz(wi)=1である。
本論文では、PzをP(w|z)の場合、P(z|w)の場合、またP(w|z)*P(z|w)の場合などを試している。


さて、TPRを用いて評価実験について。
評価項目としては、再現率、適合率、F-measureに加え、Bpref、MRRという指標も評価している。
この二つは選択のみならず、その順序を考慮するときに用いる指標だそう。
比較対象はTF-IDF、PageRank,LDAで、結果はいわずもがなTPRが全ての指標で一番。

感想としてはトピック付のコーパスを利用して、それに特化したアルゴリズムである時点で、他の手法より良いのは明白であると思った。あとP(w|z)がOになってしまうという危険がはらむのではないか。そうすると共起ネットワークグラフを強連結にすることが保証されなくなりそうな気がする。。
それはさておき、PageRankのランダム遷移部分をトピックに注意して変化させるというアイデアは面白い。というかリンク解析の手法がグラフ理論や確率過程の問題、または機械学習とうまく絡んでいて美しいなあ。

2015年6月22日月曜日

コンテンツを科学する〜「コンテンツの秘密」を読んだメモ〜

先日、以下を読んだので、備忘録代わりに書評を書いておく。

コンテンツの秘密―ぼくがジブリで考えたこと (NHK出版新書)
川上 量生 (著)


本書は株式会社ドワンゴ代表取締役会長である川上量生さんがスタジオジブリで学んだことをまとめた一冊であり、本人は本書を「卒論」と位置づけている。

本書の中で色々な観点から様々な「コンテンツの定義」が登場する。一つ一つ大変興味深く、示唆に富んだ定義であるので詳しくは本書を読んでほしい。本記事では特に興味深かったコンテンツの定義を引用し、想ったことを追記しておく。

以下はアリストテレスの表現を基に筆者がコンテンツについてまとめた最初の定義である。

「コンテンツとは現実の模倣=シミュレーションである(p.41)」

つまり、コンテンツの目的としては、受け手に現実世界を模倣(疑似体験に近いか)させることと捉えれば良いと想う。これは現実の世界のあらゆる事象を含んでおり、受け手が体験した事象はもちろん、未体験ではあるが、想像できなくもない事象を含む(SFなどはこれにあたると考える)。

次に筆者オリジナルの大変興味深い定義が以下の2つである。
「小さな客観的情報量によって大きな主観的情報量を表現したもの(p.70)」

「コンテンツとは脳の中のイメージの再現である(p.89)」

部分的に類似した定義であり、「主観的情報量」≒「脳の中のイメージ」と捉えるとその関係性がわかるであろう。作り手の頭の中にある何らかの現実を模したイメージを形にし、受け手の脳内にそれを再現させることをという意味となると想う。

本書には記されていなかったが、ここでは作り手と受け手の脳内に同様のイメージを再現できる要素がそろっている必要があると考えられる。作り手にとっては、非常に大きな主観的情報量のある作品を用いたとしても、受け手にそれを再現するための要素がなければ、何も現実世界を模倣することはできない。

受け手に対して、どれだけ根源的な内容を再現・模倣させるかに依存するが、同じ人間である、同じ民族である、同じ地域で育ったなど、様々なコンテキストの共有レベルを考えて初めて、これらのコンテンツの定義は機能するとおもわれる。

そのため、人の本能に近い部分を想起させる内容は万人受けするということであろう。

本書は「コンテンツ」を分析的に捉えるための良書である。


2015年6月21日日曜日

コンセプトビデオから読み解くGoogleの共有価値観とは?〜禅とGoogleの関係性〜

先日、以下を読んだので、備忘録代わりに考えたことをまとめる。

ザ・プラットフォーム − IT企業は成果を変えるのか?(NHK出版新書)
尾原 和啓 (著)


本書では、プラットフォームを以下のように定義している。

「ある財やサービスの利用者が増加すると、その利便性や効用が増加する『ネットワーク外部性』がはたらくインターネットサービス」

このようなプラットフォームがビジネスの世界だけではなく、私たちの生活の随所で重要な役割を担うようになってきている。本書では、世界を動かす可能性も十二分に秘めているこのプラットフォームについて、著者が実際に経験した企業(Google, 楽天, リクルート)を含む様々な実事例を交えて、その特徴や課題、また未来について記されている。

この記事では、本書2章「プラットフォームの共有価値観」にあった内容が興味深かったので、その点に焦点をあて、まとめておく。

まず、プラットフォームの本質を捉えるために、共有価値観(Shared Value)を読み解くことが重要である。

共有価値観(Shared Value)は、企業分析に用いられる 7S(Seven S Model)
の中心に据えられ、その他の企業内のあらゆる要素(Strategy, Structure, Systemes, Staff, Style, Skills, Strategy)とも強く結びついているため、プラットフォーム本質を知るために欠かせない要素となるのである。


本書では、言わずと知れたIT企業であるGoogleを例にとり、
プラットフォームの本質の読み解いているが、興味深い点は、コンセプトビデオを起点として、共有価値観を分析するところだ。

Googleの製品のコンセプトビデオの随所に散りばめられた、価値観の片鱗を紡ぎ合わせて、1つのストーリーとしてまとめている。(本書ではその他Appleについても深い考察がなされている。)

これは、私の偏見かもしれないが、一部はストーリーが先にあって、後付けでコンセプトビデオから関連するシーンを抽出したと考えられるが、その洞察と構成力は深い。今後様々なジャンルで、様々なプラットフォームが台頭してくると考えられるが、このような共有価値観を読み解くといった見方をしっているだけで、捉え方の深みは代わり、そのプラットフォームとの向き合い方も変化すると考える。

それでは、Googleの例について見ていこう。


「Google Glass」のコンセプトビデオからその共有価値観を読み解いていく。2015年1月にβ版が販売されたものの、未成熟であったためか「Google Glasshole」などと揶揄され、一時的に撤退し、現在研究所における開発体制となった製品であるが、このコンセプトビデオにはGoogleの共有価値観が多分に含まれているようである。

コンセプトビデオの前半では、以下のようなシーンがある。

 1. コーヒーを飲みながら時計を見る 
  → Glassに今日の予定が表示される
 2. 続けて窓の外を見る 
  → Glassに天気予報と気温が表示される
 3. ハムエッグを食べながら、音声入力でメールを返信する
 4. 通勤途中、地下鉄が止まってしまった 
  → Glassにルート案内が表示される
 5. 見知らぬ土地で不自由なく目的地に向かって歩く傍ら、犬をなでる
 (続く)

まず、1, 2, 4から、実世界の行動や所作から予測し、ユーザーのインテンション(意図)を読んで、先回りして必要な情報を提示することを、Googleが目指していることがわかる。

次に、3, 5のシーンから、より重要なメッセージが窺い知れる。
3のシーンでは、メールを気にせずにハムエッグを食べることに集中できる。また、5のシーンでは、従来スマホの地図を見ながら歩く場合には、犬の存在に気づかないかもしれない。そこにGlassを持ち込むことで、利用者に新しい気付きを与えている。

この3, 5のシーンのコンセプトこそが、近年シリコンバレーでも注目されている「マインドフルネス」という考え方である。マインドフルネスとは一言でいえば、「雑事や雑念にとらわれず、目の前のことに集中できるようになることで、日常の何気ないことから高い満足を得られるようになること」である。
Glassはメールを気にせずに、ハムエッグのゆっくりと味わい、道に迷って焦ることなく、かわいい犬と触れ合うことを支援するデバイスである。

以上のように、Google Glassのコンセプトビデオからは、予測して必要な情報を提示することで、雑事を退け、本人の日常のマインドフルネスを向上させるといった、共有価値観が読み取ることができるわけである。

このようなコンセプトがわかれば、同社の他の実験中のサービスである、オートナビゲーションカーも、ユーザの運転という雑事を減らし、(運転が目的の人は別であろうが)、運転中のコミュニケーションや見える景色を存分に味わうための仕組みととらえることができるようになる。

さらに面白いことには、このGoogleの共有価値観は日本の禅に通ずる要素があるという著者の洞察である。すなわち、マインドフルネスは近年Googleを中心に流行となりつつあるが、日本の禅の思想がこれと類似した要素を多く持つ。

例えば、以下の曹洞宗関連ページから関連性を考えてみる。

禅の極意!!〜「不立文字」の世界〜
「禅生活とは作務(仕事)や食事や洗面などの日常生活の中の些事を、その些事を大事と悟らせること」と記されており、これは何気ない日常の重要性を改めて知ることに通ずることである。
また、「『甘い』ということを伝えるときに、いくら口で表現してもわからない。同じ砂糖の甘さでも白砂糖の甘さと黒砂糖の甘さは違うし、果物でもイチゴの甘さと柿の甘さは違います。この甘さを本当に知るには自分が味わってみる以外にはわかりようがない。(『言詮不及、意路不到』などという)」からも、日常の五感を通した実体験を重要視し、そのために座禅を行うことがわかる。

日本の禅の考え方はあくまでも、只管打坐、座禅といったメンタル面の強化を手段としてマインドフルネスの実現をはかるが、GoogleはGlassという技術を以て、同様の課題の解決に挑んでいるといえる。時代も場所も、何もかも異なる両者が、共有価値観という軸で比較されるとこのような類似性を持つことがわかる。

もはや、プラットフォームに限った話ではないと思うが、このようなサービスの背後にある重要な共有価値観を理解することの重要性や、共有価値観の普遍性について大変勉強になる一冊であった。

2015年5月5日火曜日

蛇の模様を作ってみた -チューリングが残した数式-

5月3日(日)所さんの目がテン!を見て興味深かったので投稿する。

今イミテーションゲームでも話題の、アラン・チューリングが生物の模様に関して以下のような説を提唱したようである。

「局所的ないくつかのルールのみによって、大域的な模様は決定づけられる。」
⇒チューリング・パターン(Wikipedia)

本説の検証実験のため、番組内では、枡アナらが約1万枚のオセロを用いて手作業による検証を試みていた。

しかし、20時間もの時間がかかる非効率的な作業に思われたので、今回プログラムを用いて出来上がった模様を公開する。

前提:正六角形を敷き詰めてつくられる盤上において、各マスは白か黒の2値をとる。

ルールは以下の2つである。
 1. 自分の周り(自分と接する6マス)に、自分と異なる色のマスが4つ以上存在する場合、自分は異なる色に変化する。
 2.自分の周りの周り(自分と接する6マスと、その6マスと接する12マス:計18マス)に、自分と異なる色のマスが1つも存在しない場合、自分は異なる色に変化する。

以下は実行例を示す。(盤面は100×500マス)

1. 初期値はランダムで与える。

2. ルールの適用(1回目)

3. ルールの適用(2回目)

4. ルールの適用(5回目)

5回目以降は、ほぼ同様の状態が繰り返し続く。
蛇の模様と言われれば、蛇の模様に見えないこともない。

今後、この他のルールを適用し、蛇以外の模様についても表現できれば良いと思う。

参考:六角形版ライフゲームを作ってみた
http://hunayasu.hatenablog.com/entry/2014/04/20/233508

※上記プログラムを参考に、色変化のルール部分、ロジック部分を修正した。


2015年4月26日日曜日

知っておきたいコーヒー豆知識 -コーヒー豆の質はいかにして決まるか?-

  • コーヒーの木の品種には、主にアラビカ種とロブスタ種があり、大抵のコーヒー屋さんで売っているコーヒー豆はアラビカ種である。
  • アラビカ種のほうが味は美味しい。一方ロブスタ種のほうが病害虫に強いため、低価格コーヒーの増量のためなどに使用される。
  • コーヒー豆の違いは基本的に栽培された産地による。標高、豆のサイズ、欠点豆の少なさが良質な豆を決める3つの指標である。
  • コーヒー豆を精製する方法は主に乾式と湿式の2種類あり、この精製方法によって大きく味が変わる。

 コーヒーは数十種類の品種があるが、飲用目的で栽培されているのは主に「アラビカ種」と「ロブスタ種」の2種類で、アラビカ種がコーヒー生産量の70〜80%を占めている。ロブスタ種が残りの20〜30%を占めているが、えぐみがあり、ストレートで飲むのには適していない。つまり普段お店でストレートで飲んでいるコーヒーや、売られているコーヒー豆は全てアラビカ種ということだ。
 ではロブスタ種はどのような目的で使用されているのか。アラビカ種よりも病害虫に強く、低地で育つため栽培しやすいというメリットがある。そのため低コストであり、缶コーヒーやインスタントコーヒーなどの増量剤として使われることが多い。またブレンドコーヒーに一定の割合で入れることで、味の引き立て役となる場合もあるようだ。そしてロブスタ種はコーヒー独特の苦みや渋みが強く出ることから、アイスコーヒーで苦みを出すためによく用いられる。

 それでは、同品種の中での違いはどこから生まれるのか。豆の違いは栽培された産地で決まると考えてよい。特に高地産のコーヒーほど良質なものになる。コーヒー豆には産地名がつけられ、標高はグレードを示す指標となっている。また、豆のサイズは大きいもののほうが良質であり、サイズもひとつの指標である。そして欠点豆と呼ばれる未成熟豆、発酵豆、虫食い豆、死豆などが少ないことも重要な指標である。これらはハンドピックと呼ばれる手作業で除去されるが、生産者によって精度が異なる。
 昔は出荷された港レベルでしか判別できなかったが、今では産地が明確にわかるようになったため高品質になってきている。

 最後に、育ったコーヒーを精製する、つまりコーヒーの実から豆を取り出す工程でも味は大きく変わる。水で綺麗に洗い流して取り出す方法は湿式と呼ばれ、雑味がなくクリーンな味わいとなる。一方、水を使わずに天日干しして実を乾かし、割って取り出す方法を乾式と言う。少し発酵したような独特の香りがあり、最近注目を浴びている。

まとめ:以下の3つ観点でコーヒー豆の質が決まる
①品種は何か?(アラビカ?ロブスタ?)
②産地はどこか?(栽培環境はどうか?)
③精製方法は何か?(乾式?湿式?)

参考:
 
http://www.amazon.co.jp/コーヒー-おいしさの方程式-田口-護/dp/4140332824